

Kurz gesagt
Daten haben zwei Zielgruppen mit unterschiedlichen Ansprüchen: Menschen und Maschinen. Eine Excel-Tabelle, die fürs Auge gestaltet ist, kann ein Programm wie EasyCatalog oft nicht verarbeiten. Legen Sie die Daten deshalb von Anfang an maschinenlesbar an und erzeugen Sie die übersichtlichen Ansichten für Ihr Team daraus.
Stellen Sie sich vor, Sie bitten zwei Kollegen, Ihnen den Weg zu einem Kunden zu beschreiben. Der erste schreibt: „Fahr die A7 runter, dann irgendwo Richtung Innenstadt, du siehst dann schon das große rote Gebäude, da links rein.“ Der zweite schickt Ihnen eine Adresse: Musterstraße 12, 20099 Hamburg.
Ihnen als Mensch helfen beide Varianten, die erste vielleicht sogar mehr, weil sie sich einprägt. Ihr Navigationsgerät dagegen scheitert spätestens am roten Gebäude. Es braucht die Adresse, exakt und vollständig, in einem Format, das es versteht.
Dasselbe Problem begegnet uns in Unternehmen jeden Tag, nur eben bei Daten statt beim Navigieren. Meistens steckt es in einer Excel-Datei. Warum ist eine Tabelle, die Ihnen übersichtlich erscheint, für eine Software so oft eine Sackgasse?
Tabellen für das Auge
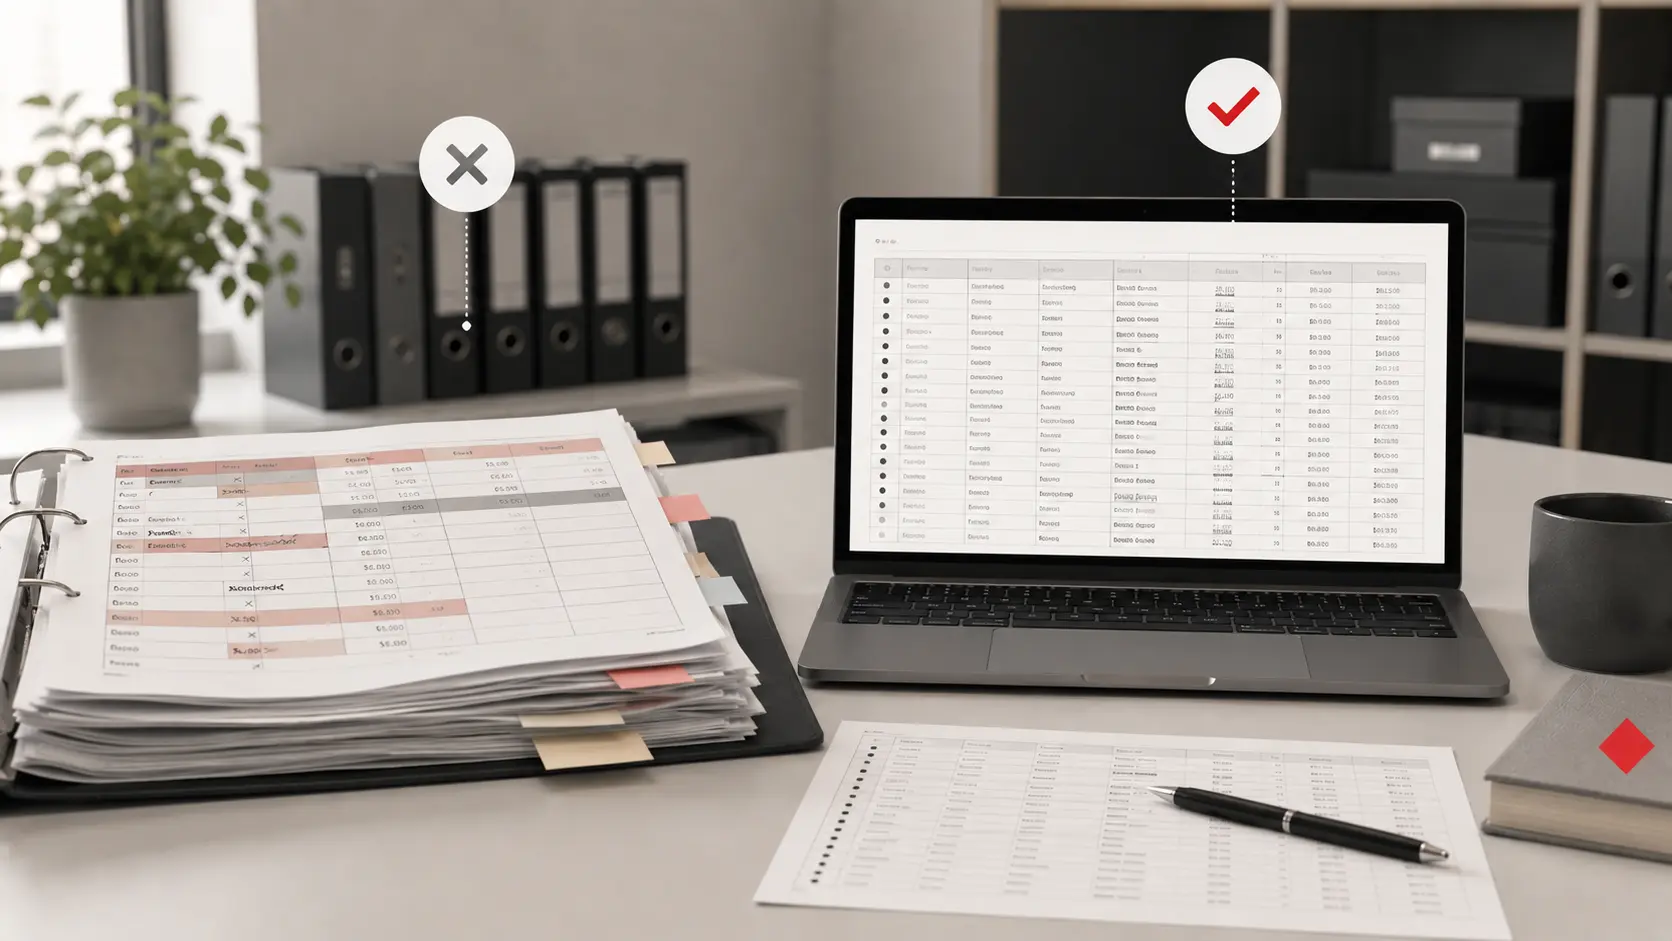
Dass Excel-Tabellen so aussehen, wie sie aussehen, ist nachvollziehbar. Menschen erstellen sie für Menschen. Also fügen sie Leerzeilen ein, um Bereiche zu trennen, heben Überschriften farbig hervor, führen Zellen zusammen, verstecken Kommentare in Fußnoten und bauen Summen mitten in Datenspalten ein. Alles, damit der Betrachter sich besser zurechtfindet.
Das Ergebnis ist oft tatsächlich hübsch. Für jede Software, die diese Daten weiterverarbeiten soll, ist es allerdings vollständig unbrauchbar.
Ein Programm liest eine Tabelle anders als ein Mensch, ob ERP-System, Automatisierungstool oder ein Publishing-Werkzeug wie EasyCatalog. Es erwartet eine klare, vorhersehbare Struktur: Spaltenköpfe in Zeile 1, Daten ab Zeile 2, eine Information pro Zelle, keine verbundenen Felder und keine dekorativen Leerzeilen dazwischen. Fehlt auch nur eines dieser Merkmale, bricht der Import ab. Oder, was noch unangenehmer ist, er läuft durch und liefert falsche Ergebnisse.
Eine Tabelle, die für das Auge optimiert ist, ist für die Maschine häufig unlesbar. Und eine Tabelle, die die Maschine lesen kann, sieht auf den ersten Blick trostlos aus.
Was „maschinenlesbar“ bedeutet
Der Begriff klingt technischer, als er ist. Im Grunde geht es um Eindeutigkeit: Jede Information steht an einem festgelegten Ort, in einem festgelegten Format, ohne Spielraum für Interpretation. Ein paar Beispiele aus der Praxis zeigen, woran es meistens hakt:
- Datumsangaben wie „15. März“ sind für Menschen klar. Aber in welchem Jahr? Eine Maschine braucht „2024-03-15“, am besten im internationalen Format ISO 8601.
- Statusangaben wie „erledigt“, „✓“ oder eine grün hinterlegte Zelle meinen für Sie alle dasselbe. Für ein System sind es drei verschiedene Werte, von denen es zwei womöglich gar nicht erkennt.
- Zusammengeführte Zellen wirken aufgeräumt. In der Datenverarbeitung belegen sie jedoch mehrere Felder, von denen nur eines einen Wert enthält; der Rest erscheint leer.
- Leerzeilen zur optischen Gruppierung deuten Systeme als Ende der Daten. Was danach kommt, ignorieren sie schlicht.
Das klingt nach Kleinigkeiten. Unsere Erfahrung zeigt aber, dass genau diese Kleinigkeiten entscheiden, ob ein Import in zwei Minuten durchläuft oder Stunden manueller Nacharbeit nach sich zieht.
Die typische Lieferung aus der Praxis
Diese Situation erleben wir in fast jedem Projekt für datengetriebene Druckprodukte, also Kataloge, Preislisten oder Produktdatenblätter. Die Idee dahinter überzeugt: Der Kunde hat seine Produktdaten, wir übernehmen sie und setzen daraus automatisiert das fertige Druckstück zusammen. Werkzeuge wie EasyCatalog, ein Publishing-Plugin für Adobe InDesign, das Datenbankfelder direkt mit Layouts verknüpft, sind genau dafür gemacht.
Die gelieferte Excel-Datei sieht dann aber so aus: Produktgruppen sind durch farbige Kopfzeilen getrennt, Leerzeilen gliedern das Blatt optisch, Preise stehen mit Währungssymbol direkt in der Zelle, und die Varianten eines Produkts verteilen sich über mehrere zusammengeführte Zeilen. Dazu kommen gelegentlich Hinweise in Klammern, die nur die Vertriebsmitarbeiterin versteht, die die Datei angelegt hat.
Ein Mensch kann das alles lesen. EasyCatalog kann nicht erkennen, dass die orange hinterlegte Zeile eine Kategorie markiert und keine Datenzeile ist. Es kann nicht wissen, dass „1.299,– €“ eine Zahl ist, mit der gerechnet werden soll. Und es kann nicht erschließen, welche der vier zusammengeführten Zellen den eigentlichen Produktnamen enthält. Die Daten sind also vorhanden, aber nicht in einer Form, in der man sie nutzen kann, und dieser Unterschied ist grundlegend.
Wo zwei Welten aufeinandertreffen
Solange eine Tabelle nur intern genutzt wird, entsteht kein Problem. Ihre Mitarbeiterin öffnet die Datei, versteht die Farben, kennt die Leerzeilen, und alles funktioniert wunderbar.
Schwierig wird es in dem Moment, in dem die Daten in ein anderes System fließen sollen: in ein Warenwirtschaftssystem, eine Datenbank, ein Automatisierungstool oder in EasyCatalog.
Wie viel Arbeit steckt in der Datentransformation?
Ab hier beginnt eine oft unterschätzte Aufgabe, die „Datentransformation“, also die manuelle Umwandlung der menschenlesbaren in eine maschinenlesbare Form. Jemand muss Leerzeilen entfernen, zusammengeführte Zellen auflösen, Farbinformationen als Textwerte neu erfassen und Einheiten aus den Zellen herauslösen. Dieser Aufwand ist beträchtlich, er fällt bei jedem Projekt neu an, und er ließe sich vollständig vermeiden.
Zwei Ansichten, eine Quelle
Müssen Sie sich also zwischen hübsch und funktional entscheiden? Nicht unbedingt. Hilfreicher ist die Frage, wo die Datenquelle entsteht und wer sie wie nutzt. Ein sinnvoller Ansatz trennt Datenhaltung und Darstellung klar voneinander:
Die Rohdaten
Die maschinenlesbare Tabelle ist die Quelle der Wahrheit. Sie bleibt sauber strukturiert und wird für die Darstellung nicht verändert.
Für Importe, Automatisierung und die Produktion
Die Ansichten
Separate Ansichten, Berichte oder Auswertungen entstehen aus den Rohdaten und dürfen gern farbig und übersichtlich sein.
Für das Team
Viele Systeme bieten genau diese Möglichkeit, von Excel über Google Sheets bis zu modernen Datenbank-Tools. Mit Pivot-Tabellen, Dashboards oder Berichtsvorlagen erzeugen Sie aus einer strukturierten Rohdatenbasis das, was das Auge erwartet, ohne die Quelle anzutasten.
Unsere Empfehlung
Ihre Tabellen müssen dafür nicht hässlicher werden. Legen Sie Ihre Daten von Anfang an maschinenlesbar an, dann sparen Sie bei jedem Systemwechsel, jedem Import und jedem Automatisierungsprojekt erheblich Zeit. Legen Sie darüber eine saubere Darstellungsschicht, bekommt Ihr Team lesbare Berichte und die Produktion verwertbare Daten. Prüfen Sie Ihre wichtigsten Tabellen daraufhin, ob Sie beides haben und wissen, was wozu dient.